
Fehlerbehebung
Warum eine gescannte PDF nicht direkt in Markdown umgewandelt werden kann
Eine Seite kann voller Wörter aussehen und trotzdem keinen extrahierbaren Text enthalten. PDFLume liest eine vorhandene Textebene und erkennt keine Buchstaben im Bild einer gescannten Seite.
Öffnen PDF in MarkdownPrüfen, ob die Seite eine nutzbare Textebene hat
Versuche, einen Satz auszuwählen und in einen Texteditor zu kopieren. Ist nur das gesamte Seitenbild auswählbar, kann es eine reine Bilddatei sein. Ist kopierter Text unleserlich, könnten Schriftzuordnung oder frühere OCR die Ursache sein. Auswahl ist eine erste Prüfung, keine Garantie korrekter Extraktion.
Manche PDFs mischen Scans und Textseiten. Funktioniert Seite 1, kann eine andere trotzdem OCR benötigen. Prüfe die tatsächlich zu konvertierenden Seiten.
Den unterstützten Ablauf testen
Das integrierte Beispiel verwendet dieselbe Textextraktion wie deine Datei. Es ist ein einfaches erzeugtes Dokument und demonstriert weder OCR noch komplexe Tabellen oder genaue Layout-Erhaltung.
- Öffne PDF in Markdown und wähle Beispieldateien ausprobieren für eine erzeugte Text-PDF oder wähle deine eigene nicht verschlüsselte PDF.
- Wähle die benötigten Seiten. Lass Quellseitenmarkierungen aktiviert, um Text zur PDF-Seite zurückzuverfolgen.
- Wähle In Markdown umwandeln. Vergleiche das bearbeitbare Ergebnis mit dem Original, besonders Überschriften, Spalten, Tabellen und Zeilenumbrüche.
- Kopiere Markdown oder lade die .md-Datei herunter. Korrigiere den Text vor dem Teilen oder weiterer Verwendung.
Fehlenden Text und Teilergebnisse verstehen
Liefert keine ausgewählte Seite Text, stoppt PDFLume mit einer entsprechenden Fehlermeldung, statt einen leeren Markdown-Download als Erfolg anzubieten. OCR ist nicht enthalten. Du kannst weiterhin PNG exportieren oder die PDF teilen.
Fehlt nur auf manchen Seiten Text, enthält Markdown dort Platzhalter und das Werkzeug warnt vor den betroffenen Seiten. Ein Platzhalter ist keine Transkription des fehlenden Inhalts.
Für Wörter aus einem Scan zuerst OCR verwenden
Erstelle mit einem vertrauenswürdigen OCR-Werkzeug eine durchsuchbare PDF mit Textebene. Prüfe Namen, Zahlen und Zeichensetzung und lade die neue PDF in PDFLume. OCR kann blasse Schrift, Handschrift und ungewöhnliche Layouts falsch lesen; die Konvertierung repariert diese Erkennungsfehler nicht.
Brauchst du nur ein Seitenbild, nutze PDF in PNG. Für eine Seitenauswahl nutze PDF teilen. Beide benötigen keine Worterkennung. Dateien dieser Browser-Werkzeuge werden auf deinem Gerät verarbeitet; externe OCR-Dienste können andere Datenschutzregeln haben.
Beispiele und Testmethode
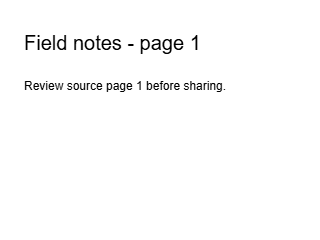
Dieser echte Seitenexport ist im reinen Bild-PDF-Testfall als Bild eingebettet. Seine sichtbaren Wörter sind Pixel; der Testfall hat keine Textebene.
Ergebnisbild herunterladen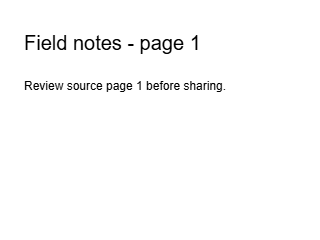
- Reine Bild-PDF · erwarteter Fehler wegen fehlenden Texts
- PDF mit Textebene · unterstützter Kontrollfall
- Echte Markdown-Ausgabe
- Konvertierungsnachweise und Parameter
Am 8. Oktober 2026 anhand von Textextraktion, NO_TEXT-Behandlung und aktuellen Einstellungen von PDFLume SaaS 0.1.0 geprüft. Die dreiseitige Text-PDF wurde mit Seitenmarkierungen konvertiert. Der Bild-PDF-Testfall wurde durch dieselbe Engine verarbeitet und lieferte NO_TEXT. Nachweise enthalten Parameter und Prüfsummen. Die synthetische Bild-PDF zeigt die OCR-Grenze, keine Scannerqualität oder OCR-Genauigkeit.