
Solução de problemas
Por que um PDF digitalizado não pode ser convertido diretamente para Markdown
Uma página pode parecer cheia de palavras sem conter texto extraível. O PDFLume lê uma camada de texto existente; não reconhece letras dentro da imagem de uma página digitalizada.
Abrir PDF para MarkdownConfira se a página tem uma camada de texto utilizável
Tente selecionar uma frase e copiá-la para um editor de texto simples. Se apenas a imagem inteira for selecionável, o arquivo pode conter só imagens. Se o texto copiado sair ilegível, o problema pode ser o mapeamento de fontes ou um OCR anterior. A seleção é uma primeira verificação útil, não garantia de extração correta.
Alguns PDFs misturam páginas digitalizadas e páginas de texto. Um documento que funciona na página 1 ainda pode precisar de OCR em outra. Confira as páginas que pretende converter.
Teste o fluxo compatível
O exemplo incluído passa pela mesma extração de texto do seu arquivo. É um documento simples gerado e não demonstra OCR, tabelas complexas nem preservação exata de layout.
- Abra PDF para Markdown e escolha Testar arquivos de exemplo para um PDF gerado com texto, ou escolha seu próprio PDF desbloqueado.
- Selecione as páginas necessárias. Mantenha os marcadores de origem ativados para rastrear o texto até sua página PDF.
- Escolha Converter para Markdown. Compare a saída editável com o original, especialmente títulos, colunas, tabelas e quebras de linha.
- Copie Markdown ou baixe o arquivo .md. Faça correções antes de compartilhar ou usar o texto em outro fluxo.
Entenda o erro de ausência de texto e os resultados parciais
Se nenhuma página selecionada produzir texto, o PDFLume para com um erro de ausência de texto selecionável, em vez de apresentar um Markdown vazio como sucesso. OCR não está incluído. Você ainda pode exportar PNG ou dividir o PDF.
Se apenas algumas páginas não tiverem texto, o Markdown inclui uma indicação de ausência de texto extraível nessas páginas e a ferramenta avisa quais precisam de atenção. Essa indicação não é transcrição do conteúdo ausente.
Use OCR primeiro se precisar das palavras de uma digitalização
Use uma ferramenta de OCR em que confie para criar um PDF pesquisável com camada de texto. Revise nomes, números e pontuação, depois carregue o novo PDF no PDFLume. OCR pode interpretar mal impressão fraca, escrita manual e layouts incomuns; a conversão não repara esses erros.
Se precisar apenas de uma imagem da página, use PDF para PNG. Se precisar de algumas páginas, use Dividir PDF. Nenhuma tarefa exige reconhecer palavras. Os arquivos selecionados nestas ferramentas são processados no dispositivo; um serviço externo de OCR pode ter outra política de privacidade.
Exemplos e método de teste
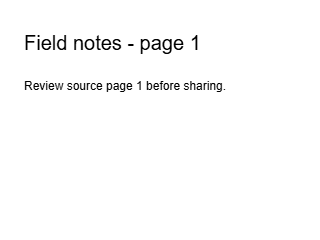
Esta exportação real de página é incorporada como imagem no PDF de teste apenas com imagens. Suas palavras visíveis são pixels; o arquivo não tem camada de texto.
Baixar imagem de resultado
- PDF apenas com imagens · erro esperado de ausência de texto
- PDF com camada de texto · controle compatível
- Saída Markdown real
- Evidências e parâmetros de conversão
Revisado conforme a extração de texto, o tratamento de NO_TEXT e os controles atuais do PDFLume SaaS 0.1.0 em 8 de outubro de 2026. O PDF de três páginas com texto foi convertido com marcadores ativados. O arquivo só com imagens passou pelo mesmo mecanismo e retornou NO_TEXT. As evidências registram parâmetros e hashes. Este PDF sintético demonstra o limite de OCR, não qualidade de scanner nem precisão de OCR.