
Solución de problemas
Por qué un PDF escaneado no puede convertirse directamente a Markdown
Una página puede parecer llena de palabras sin contener texto extraíble. PDFLume lee la capa de texto existente; no reconoce letras en una imagen escaneada.
Abrir PDF a MarkdownComprueba si la página tiene una capa de texto útil
Intenta seleccionar una frase y copiarla a un editor de texto. Si solo se selecciona la imagen completa, puede ser un PDF de solo imagen. Si el texto se copia mal, puede fallar el mapa de fuentes o un OCR anterior. Seleccionar es una comprobación inicial, no una garantía.
Algunos PDF mezclan escaneos y páginas con texto. Aunque funcione la página 1, otra puede necesitar OCR. Revisa las que vas a convertir.
Prueba el proceso compatible
La muestra utiliza la misma extracción que tu archivo. Es un documento generado sencillo y no demuestra OCR, tablas complejas ni conservación exacta del diseño.
- Abre PDF a Markdown y elige Probar archivos de muestra para un PDF generado con texto, o elige tu PDF sin contraseña.
- Selecciona las páginas necesarias. Mantén los marcadores si quieres relacionar el texto con su página original.
- Elige Convertir a Markdown. Compara el texto editable con el original, especialmente encabezados, columnas, tablas y saltos de línea.
- Copia Markdown o descarga el .md. Corrige antes de compartir o usarlo en otro proceso.
Comprende el error sin texto y los resultados parciales
Si ninguna página devuelve texto, PDFLume se detiene con un error en lugar de ofrecer una descarga vacía como éxito. No incluye OCR. Aún puedes exportar PNG o dividir el PDF.
Si solo algunas páginas carecen de texto, Markdown incluye un marcador y la herramienta avisa qué páginas revisar. Ese marcador no transcribe el contenido ausente.
Utiliza OCR primero si necesitas las palabras de un escaneo
Utiliza una herramienta OCR de confianza para crear un PDF buscable con texto. Revisa nombres, números y puntuación y carga el PDF nuevo en PDFLume. OCR puede interpretar mal impresión tenue, escritura manual y diseños inusuales; la conversión no repara esos errores.
Si solo necesitas una imagen, utiliza PDF a PNG. Para algunas páginas, utiliza Dividir PDF. Ninguna tarea necesita reconocer palabras. PDFLume procesa localmente; los servicios OCR externos pueden tener otras políticas.
Muestras y método de prueba
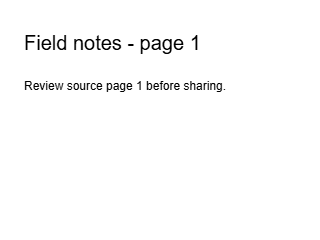
Esta exportación real está incrustada como imagen en el PDF de prueba. Las palabras visibles son píxeles; no hay capa de texto.
Descargar imagen resultante
- PDF de solo imagen · error sin texto esperado
- PDF con capa de texto · control compatible
- Resultado Markdown real
- Pruebas y parámetros de conversión
Revisado con PDFLume SaaS 0.1.0, extracción de texto, gestión de NO_TEXT y controles actuales el 8 de octubre de 2026. El PDF de tres páginas se convirtió con marcadores. El de solo imagen devolvió NO_TEXT con el mismo motor. Las pruebas registran parámetros y hashes. Esta muestra demuestra el límite OCR, no calidad del escáner ni precisión OCR.